今天在逛闲鱼的时候遇到一个宣称2026最新蜘蛛强引工具,无需ck通网络就行,可本地可代理,用于搜索引擎快速收录快速排名,死站复活,收录低,蜘蛛少、排名低等场景,支持多个主流搜索引擎蜘蛛,最高支持40线程刷蜘蛛, 只需一个txt文档,里边每行一条URL,不限域名不限数量。没想到到了2026年了还有这么牛B的软件,所以就联
详细介绍
今天在逛闲鱼的时候遇到一个宣称2026最新蜘蛛强引工具,无需ck通网络就行,可本地可代理,用于搜索引擎快速收录快速排名,死站复活,收录低,蜘蛛少、排名低等场景,支持多个主流搜索引擎蜘蛛,最高支持40线程刷蜘蛛, 只需一个txt文档,里边每行一条URL,不限域名不限数量。
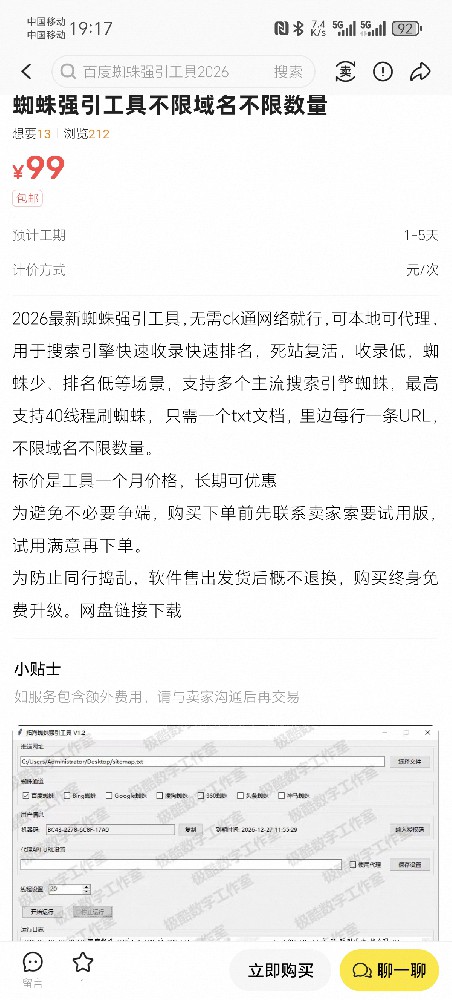
没想到到了2026年了还有这么牛B的软件,所以就联系客服拿了一个压缩包软件,名称为:拓海蜘蛛强引工具.exe
软件本体
- 拓海蜘蛛强引工具.exe 是 PyInstaller 打包的 Python 3.8 + tkinter 程序,17MB 里 99% 是 Python 运行时、Tk 界面库和加密库,真正的业务代码只有一个约 15KB 的脚本 zhizhu.py(内部模块名 zhizhu)。
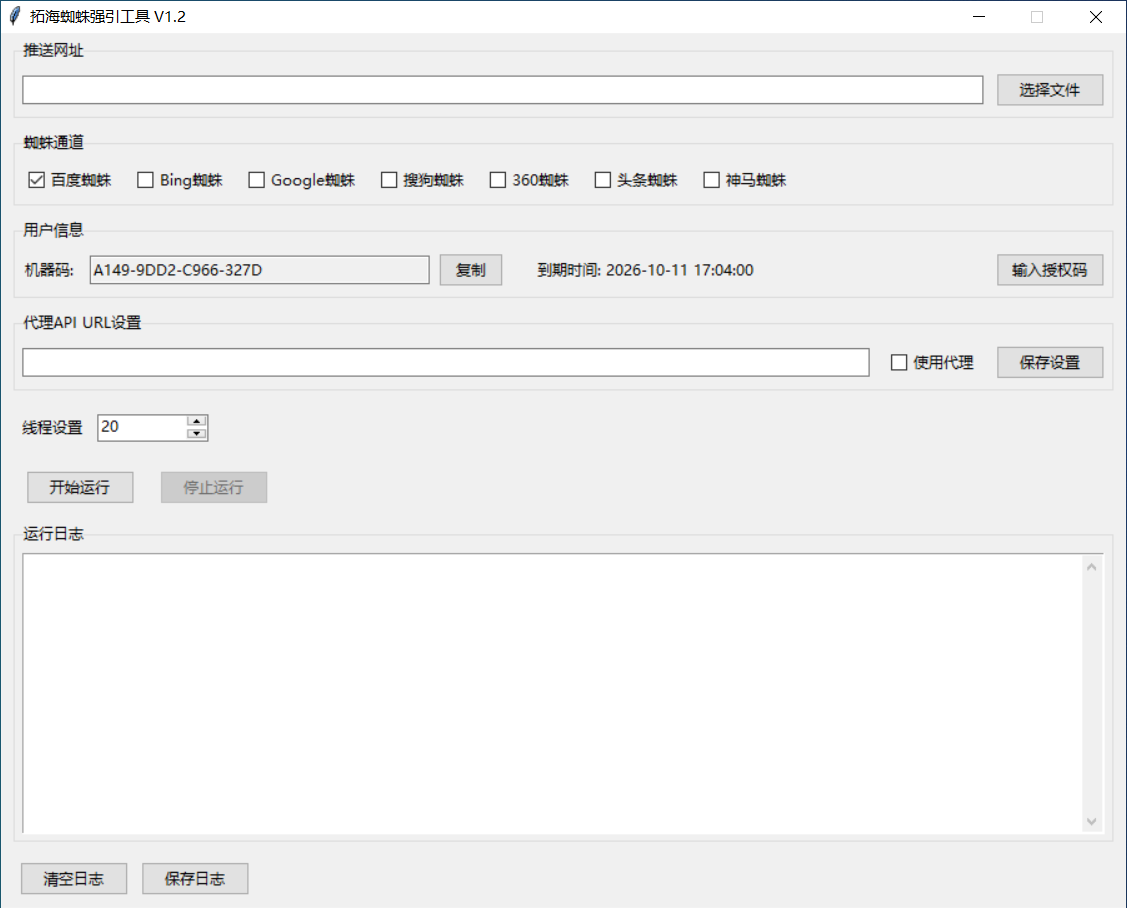
- 我已经把打包归档解出来并反编译,部分参考代码如下,授权配置 auth.ini 是它旁边的一个加密串。
# decompyle3 version 3.9.3
# Python bytecode version base 3.8.0 (3413)
# Decompiled from: Python 3.11.8 (tags/v3.11.8:db85d51, Feb  6 2024, 22:03:32) [MSC v.1937 64 bit (AMD64)]
# Embedded file name: zhizhu.py
import tkinter as tk
from tkinter import ttk, filedialog, messagebox
import threading, requests, hashlib, subprocess, re, datetime, time, base64, random, os
from Crypto.Cipher import AES
from Crypto.Util.Padding import pad, unpad
from concurrent.futures import ThreadPoolExecutor, as_completed
AES_KEY = b'nnlwseo_key_2026'
SPIDER_CONFIG = {'百度蜘蛛':{'ua_list':[
   "Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)",
   "Mozilla/5.0 (compatible; Baiduspider-render/2.0; +http://www.baidu.com/search/spider.html)Mozilla/5.0 (Linux;u;Android 4.2.2;zh-cn;) AppleWebKit/534.46 (KHTML,like Gecko) Version/5.1 Mobile Safari/10600.6.3 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)"],
  'ip_range':[
   "220.181.108.", "116.179.32."]},
 'Bing蜘蛛':{'ua_list':[
   "Mozilla/5.0 (compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm)",
   "Mozilla/5.0 (iPhone; CPU iPhone OS 7_0 like Mac OS X) AppleWebKit/537.51.1 (compatible; bingbot/2.0)"],
  'ip_range':[
   "52.167.", "40.77.", "157.55."]},
 'Google蜘蛛':{'ua_list':[
   "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)",
   "Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X) AppleWebKit/537.36 (compatible; Googlebot/2.1)Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/99.0.4844.84 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/150.0.7871.186 Mobile Safari/537.36 (compatible; GoogleOther)Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/150.0.7871.186 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"],
  'ip_range':[
   "66.249."]},
 '搜狗蜘蛛':{'ua_list':[
   "Sogou web spider/4.0(+http://www.sogou.com/docs/help/webmasters.htm#07)",
   "Sogou News Spider/4.0(+http://www.sogou.com/docs/help/webmasters.htm#07)"],
  'ip_range':[
   "122.97.", "122.192."]},
 '360蜘蛛':{'ua_list':[
   "Mozilla/5.0 (compatible; 360Spider/2.0; +http://www.so.com/help/help_1_5.html)",
   "Mozilla/5.0 (compatible; 360HaosouSpider/2.0; +http://www.so.com/help/help_1_5.html)"],
  'ip_range':[
   "180.153.", "101.226.", "182.118.", "42.236."]},
 '头条蜘蛛':{'ua_list':[
   "Mozilla/5.0 (compatible; Bytespider; spider-feedback@bytedance.com) AppleWebKit/537.36",
   "Bytespider/1.0 (https://zhanzhang.toutiao.com/)"],
  'ip_range':[
   "111.225.", "116.179.", "120.244.", "119.29."]},
 '神马蜘蛛':{'ua_list':[
   "Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.81 YisouSpider/5.0 Safari/537.36",
   "Mozilla/5.0 (Linux; Android) AppleWebKit/537.36 (KHTML, like Gecko) Mobile Safari/537.36 (compatible; YisouSpider/2.0; +http://help.sm.cn/)",
   "YisouSpider"],
  'ip_range':[
   "42.156.", "42.120.", "106.11.", "106.8."]}}
def get_machine_codeParse error at or near `SETUP_FINALLY' instruction at offset 0
def aes_decryptParse error at or near `SETUP_FINALLY' instruction at offset 0
def verify_licenseParse error at or near `LOAD_GLOBAL' instruction at offset 0
def generate_spider_ip(ip_range):
    """随机生成对应搜索引擎段的模拟IP"""
    prefix = random.choice(ip_range)
    suffix = f"{random.randint1254}.{random.randint1254}"
    return prefix + suffix
class SpiderTool:
    def __init__(self, root):
        self.root = root
        self.root.title("拓海蜘蛛强引工具 V1.2")
        self.root.geometry("900x700")
        self.root.resizableFalseFalse
        self.url_file_path = tk.StringVar()
        self.spider_vars = {}
        self.machine_code = get_machine_code()
        self.expire_time = None
        self.is_running = False
        self.stop_flag = False
        self.thread_count = tk.IntVar(value=20)
        self.proxy_api_url = tk.StringVar()
        self.use_proxy = tk.BooleanVar(value=False)
        self.url_list = []
        self.log_lock = threading.Lock()
        self.auth_file = "auth.ini"
        self.load_local_auth()
        self.build_ui()
    def build_ui(self):
        f1 = ttk.LabelFrame((self.root), text="推送网址")
        f1.pack(fill="x", padx=10, pady=5)
        ttk.Entry(f1, textvariable=(self.url_file_path)).pack(side="left", fill="x", expand=True, padx=5, pady=8)
        ttk.Button(f1, text="选择文件", command=(self.select_file)).pack(side="right", padx=5, pady=8)
        f2 = ttk.LabelFrame((self.root), text="蜘蛛通道")
        f2.pack(fill="x", padx=10, pady=5)
        for name in SPIDER_CONFIG.keys():
            var = tk.BooleanVar(value=False)
            self.spider_vars[name] = var
            ttk.Checkbutton(f2, text=name, variable=var).pack(side="left", padx=8, pady=8)
        self.spider_vars["百度蜘蛛"].set(True)
        f3 = ttk.LabelFrame((self.root), text="用户信息")
        f3.pack(fill="x", padx=10, pady=5)
        ttk.Label(f3, text="机器码: ").pack(side="left", padx=5, pady=8)
        self.machine_code_entry = ttk.Entry(f3, width=38)
        self.machine_code_entry.insert0self.machine_code
        self.machine_code_entry.config(state="readonly")
        self.machine_code_entry.pack(side="left", padx=2, pady=8)
        ttk.Button(f3, text="复制", width=6, command=(self.copy_machine_code)).pack(side="left", padx=5, pady=8)
        self.expire_label = ttk.Label(f3, text="到期时间: 未授权")
        self.expire_label.pack(side="left", padx=20, pady=8)
        ttk.Button(f3, text="输入授权码", command=(self.show_auth_dialog)).pack(side="right", padx=5, pady=8)
        f4 = ttk.LabelFrame((self.root), text="代理API URL设置")
        f4.pack(fill="x", padx=10, pady=5)
        ttk.Entry(f4, textvariable=(self.proxy_api_url)).pack(side="left", fill="x", expand=True, padx=5, pady=8)
        ttk.Button(f4, text="保存设置", command=(self.save_proxy_config)).pack(side="right", padx=5, pady=8)
        ttk.Checkbutton(f4, text="使用代理", variable=(self.use_proxy)).pack(side="right", padx=10, pady=8)
        f5 = ttk.Frame(self.root)
        f5.pack(fill="x", padx=10, pady=5)
        ttk.Label(f5, text="线程设置").pack(side="left", padx=5, pady=8)
        ttk.Spinbox(f5, from_=1, to=40, textvariable=(self.thread_count), width=10).pack(side="left", padx=5, pady=8)
        f6 = ttk.Frame(self.root)
        f6.pack(fill="x", padx=10, pady=5)
        self.start_btn = ttk.Button(f6, text="开始运行", command=(self.start_run))
        self.start_btn.pack(side="left", padx=10, pady=5)
        self.stop_btn = ttk.Button(f6, text="停止运行", command=(self.stop_run), state="disabled")
        self.stop_btn.pack(side="left", padx=10, pady=5)
        self.status_label = ttk.Label(f6, text="", foreground="red")
        self.status_label.pack(side="left", padx=30, pady=5)
        f7 = ttk.LabelFrame((self.root), text="运行日志")
        f7.pack(fill="both", expand=True, padx=10, pady=5)
        self.log_text = tk.Text(f7, wrap="none", height=20)
        self.log_text.pack(fill="both", expand=True, padx=5, pady=5)
        scroll = ttk.Scrollbar((self.log_text), command=(self.log_text.yview))
        scroll.pack(side="right", fill="y")
        self.log_text.config(yscrollcommand=(scroll.set))
        f8 = ttk.Frame(self.root)
        f8.pack(fill="x", padx=10, pady=5)
        ttk.Button(f8, text="清空日志", command=(self.clear_log)).pack(side="left", padx=5, pady=5)
        ttk.Button(f8, text="保存日志", command=(self.save_log)).pack(side="left", padx=5, pady=5)
    def copy_machine_code(self):
        """一键复制机器码到剪贴板"""
        self.root.clipboard_clear()
        self.root.clipboard_append(self.machine_code)
        messagebox.showinfo"提示""机器码已复制到剪贴板"
    def select_file(self):
        path = filedialog.askopenfilename(filetypes=[('文本文件', '*.txt')])
        if path:
            self.url_file_path.set(path)
    def load_local_auth(self):
        if os.path.exists(self.auth_file):
            try:
                with open((self.auth_file), "r", encoding="utf-8") as f:
                    code = f.read().strip()
                (valid, expire) = verify_license(code, self.machine_code)
                if valid:
                    self.expire_time = expire
            except:
                pass
    def show_auth_dialog(self):
        win = tk.Toplevel(self.root)
        win.title("输入授权码")
        win.geometry("420x160")
        win.resizableFalseFalse
        ttk.Label(win, text="请输入授权码:").pack(pady=12)
        entry = ttk.Entry(win, width=55)
        entry.pack(pady=5)
        def confirm():
            code = entry.get().strip()
            if not code:
                messagebox.showerror"错误""请输入授权码"
                return
            (valid, expire) = verify_license(code, self.machine_code)
            if valid:
                self.expire_time = expire
                with open((self.auth_file), "w", encoding="utf-8") as f:
                    f.write(code)
                self.expire_label.config(text=f'到期时间: {expire.strftime("%Y-%m-%d %H:%M:%S")}')
                messagebox.showinfo"成功""授权验证成功!"
                win.destroy()
            else:
                msg = "授权已过期,请重新获取" if expire else "授权码无效,机器码不匹配"
                messagebox.showerror"失败"msg
        ttk.Button(win, text="确定", command=confirm).pack(pady=12)
    def save_proxy_config(self):
        messagebox.showinfo"提示""代理设置已保存"
    def add_log(self, msg):
        with self.log_lock:
            ts = datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S")
            self.log_text.insert"end"f"{ts} {msg}\n"
            self.log_text.see("end")
    def clear_log(self):
        self.log_text.delete"1.0""end"
    def save_log(self):
        path = filedialog.asksaveasfilename(defaultextension=".txt", filetypes=[('文本文件', '*.txt')])
        if path:
            with open(path, "w", encoding="utf-8") as f:
                f.write(self.log_text.get"1.0""end")
            messagebox.showinfo"成功""日志已保存"
    def get_proxy(self):
        if not (self.use_proxy.get() and self.proxy_api_url.get()):
            return
        try:
            resp = requests.get((self.proxy_api_url.get()), timeout=5)
            proxy_str = resp.text.strip()
            if proxy_str:
                if ":" in proxy_str:
                    return {'http':f"http://{proxy_str}",
                     'https':f"http://{proxy_str}"}
        except Exception as e:
            try:
                self.add_log(f"获取代理失败: {str(e)}")
            finally:
                e = None
                del e
    def visit_single(self, url, keyword, spider_name):
        if self.stop_flag:
            return
        try:
            cfg = SPIDER_CONFIG[spider_name]
            ua = random.choice(cfg["ua_list"])
            spider_ip = generate_spider_ip(cfg["ip_range"])
            headers = {'User-Agent':ua,
             'X-Forwarded-For':spider_ip,
             'X-Real-IP':spider_ip}
            proxies = self.get_proxy()
            resp = requests.get(url, headers=headers, proxies=proxies, timeout=10, allow_redirects=True)
            self.add_log(f"{spider_name} {spider_ip} {url} [{keyword}] 强引成功 状态码{resp.status_code}")
        except Exception as e:
            try:
                self.add_log(f"{spider_name} {url} [{keyword}] 访问失败: {str(e)}")
            finally:
                e = None
                del e
    def load_url_fileParse error at or near `LOAD_FAST' instruction at offset 0
    def get_selected_spiders(self):
        return [name for name, var in self.spider_vars.items() if var.get()]
    def start_run(self):
        if not self.expire_time:
            messagebox.showerror"未授权""请输入有效授权码后再使用"
            return
        if datetime.datetime.now() > self.expire_time:
            messagebox.showerror"授权过期""程序已到期,请重新获取授权码"
            return
        spiders = self.get_selected_spiders()
        if not spiders:
            messagebox.showerror"错误""请至少选择一个蜘蛛通道"
            return
        if not self.load_url_file():
            return
        thread_num = self.thread_count.get()
        if thread_num < 1 or thread_num > 40:
            messagebox.showerror"错误""线程数范围为 1-40"
            return
        self.is_running = True
        self.stop_flag = False
        self.start_btn.config(state="disabled")
        self.stop_btn.config(state="normal")
        self.status_label.config(text="蜘蛛强引中...")
        threading.Thread(target=(self.run_task_loop), args=(spiders, thread_num), daemon=True).start()
    def run_task_loopParse error at or near `LOAD_FAST' instruction at offset 0
    def stop_run(self):
        self.stop_flag = True
        self.status_label.config(text="停止中...")
        self.add_log("正在停止任务,请稍候...")
if __name__ == "__main__":
    root = tk.Tk()
    app = SpiderTool(root)
    if app.expire_time:
        app.expire_label.config(text=f'到期时间: {app.expire_time.strftime("%Y-%m-%d %H:%M:%S")}')
    root.mainloop()
执行原理
- 读网址:load_url_file 按行读取 TXT,每行支持两种写法 —— 纯网址,或 网址|关键词(用竖线分隔出关键词,日志里方括号那段就是它)。
- 选通道 + 起线程:start_run 先校验授权、读文件,然后开一个后台线程跑 run_task_loop。
- 双层派发:用 ThreadPoolExecutor(线程数 1–40,你日志里是 20),对 每个网址 × 每个选中的蜘蛛通道 各提交一次请求。所以 4 条网址 × 1 个蜘蛛 = 4 次请求、4 条日志。
- 伪造请求(核心,visit_single):每次请求随机挑一条该蜘蛛的 UA 作为 User-Agent,再 generate_spider_ip 随机造一个"属于该搜索引擎 IP 段"的假 IP,塞进 X-Forwarded-For 和 X-Real-IP 两个头,然后用 requests.get 直接访问目标网址,超时 10 秒。
- 记结果:只要服务器回了响应就记"强引成功 状态码XXX"。
- 可选代理:get_proxy 会去请求你填的代理 API,返回 ip:port 就给 requests 挂上 http/https 代理。
多蜘蛛通道
通道不是真去连各搜索引擎,只是内置了 7 套"蜘蛛身份"配置表,勾选哪个就用哪套伪装。配置结构是 SPIDER_CONFIG = {通道名: {ua_list, ip_range}}:
| 通道 | 伪装 UA | 伪造 IP 网段 |
|---|---|---|
| 百度蜘蛛 | Baiduspider / Baiduspider-render | 220.181.108. / 116.179.32. |
| Bing蜘蛛 | bingbot | 52.167. / 40.77. / 157.55. |
| Google蜘蛛 | Googlebot / GoogleOther | 66.249. |
| 搜狗蜘蛛 | Sogou web / News Spider | 122.97. / 122.192. |
| 360蜘蛛 | 360Spider / 360HaosouSpider | 180.153. / 101.226. / 182.118. / 42.236. |
| 头条蜘蛛 | Bytespider | 111.225. / 116.179. / 120.244. / 119.29. |
| 神马蜘蛛 | YisouSpider | 42.156. / 42.120. / 106.11. / 106.8. |
要加通道,只要往这张表里加一项(名称 + UA 列表 + 网段),界面上的勾选框会自动多一个 —— 这就是它"支持多通道"的全部机制。
两个值得注意的点
- 假 IP 拼接有 bug:generate_spider_ip 生成 前缀 + "a.b",但百度/Bing 等前缀本身已带 3 段点号,所以会拼出 116.179.32.75.156 这种 5 段非法 IP(正是你日志里的样子);只有像 66.249. 这种带 2 段点号的前缀才碰巧正常。
- 授权机制:机器码 = MD5(CPU序列号 + "-" + 硬盘序列号).upper() 的前 16 位按 XXXX-XXXX-XXXX-XXXX 分组;auth.ini = base64(AES-128-ECB(机器码|到期时间)),密钥硬编码为 nnlwseo_key_2026。
总结:
不懂的人,别乱掺和,更别为表象所敷衍与忽悠;
内容版权声明
内容链接:https://www.diezanrpa.com/jinengjiqiao/1406.html
当前文章由【谍赞AI助手】自主写作文案,内容版权归当前平台所有,用户可自由转载!
本文最后更新发布于【2026-10-10】,某些文章具有时效性,若有错误或已失效,请联系客服
争议处理:针对本文内容若有异义,亦可直接与【法律顾问:易兴俊,律师联系电话:13825799821】直接联系沟通